Cuando las organizaciones comienzan a integrar IA en sus flujos de trabajo, un pregunta técnico domina rápidamente las conversaciones sobre infraestructura y facturación: «¿Qué son los tokens IA?«
Entender qué son los tokens IA es el primer concepto que hay que aprender al desplegar cualquier automatización en un entorno corporativo.
Un token IA es la unidad de medida fundamental para predecir sobrecostes en el uso de la IA, limitaciones de memoria y un rendimiento deficiente de las herramientas de IA.
Comprendiendo qué son los tokens IA: Traducción del lenguaje humano para la máquina
Las IAs no piensan como las personas.
Las IA que son modelos de lenguaje (LLMs) como ChatGPT, Claude, Gemini o Copilot no entienden el texto palabra por palabra, ni leen letras individuales.
Lo que van a hacer es traducir palabras y trozo de palabras a un lenguaje matemático que si pueden procesar.
Los modelos no leen palabras, procesan fragmentos estadísticos
- La unidad mínima de procesamiento computacional: Un token es un fragmento de palabra o una palabra completa. Un token no equivale siempre a una palabra completa.
- Fragmentación morfológica: Una palabra corta y habitual como «mar» representa un único token. Para palabras más complejas o compuestas como «desestructuración» la IA tendrá que dividir la palabra en varios tokens (fragmentos) como «des«, «estructur«, «ación«.
La diferencia de fragmentación según el idioma (Por qué el español consume más)
- Optimización de la arquitectura base: La mayoría de los modelos IA se han entrenado con contenido en inglés. Su diccionario interno de fragmentos de palabras está diseñado para la morfología anglosajona.
- Penalización por procesamiento multilingüe: Al escribir un prompt en español, el modelo a menudo no reconoce palabras enteras como unidades básicas de su vocabulario principal. Una instrucción que en inglés consume 20 tokens, al traducirse al español puede requerir 35 o 40 tokens para procesar el mismo significado.
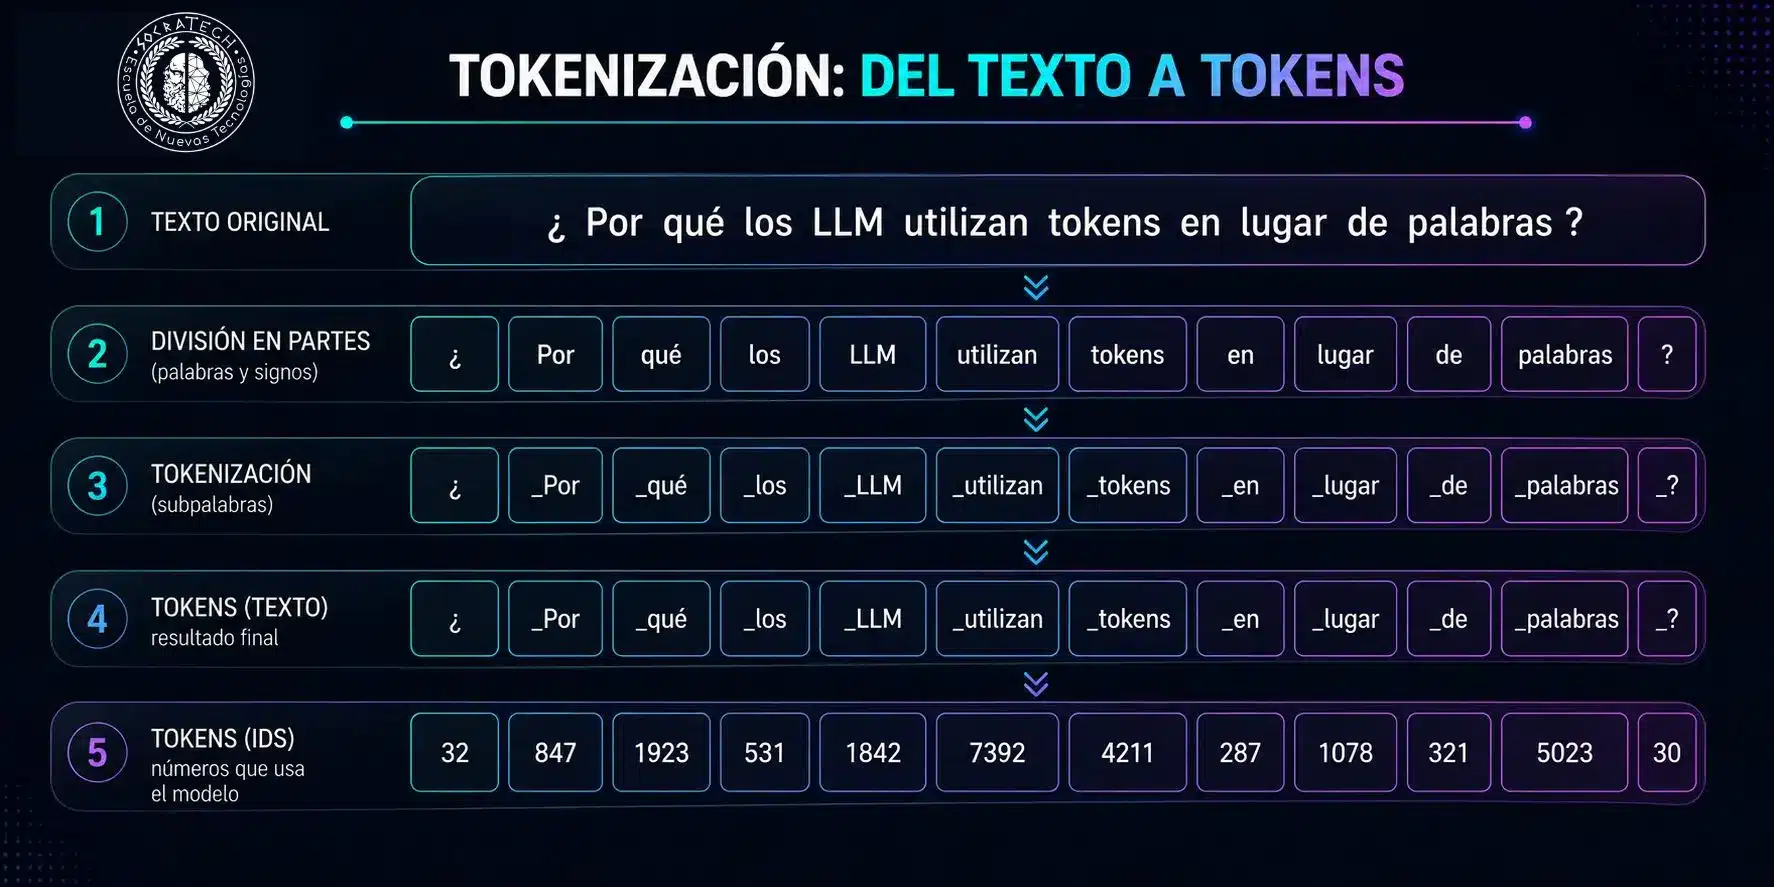
- Herramientas de auditoría: Para poder ver cómo funciona la tokenización (dividir palabras en fragmentos, y luego transformarlas en números) tenemos este Tokenizer oficial de OpenAI que nos lo muestra.
- Impacto estructural en el desarrollo: Por todo lo que hemos visto, sabemos que usar la IA en español gasta más tokens. Siempre hay que tener esto en cuenta a la hora de inyectar grandes volúmenes de documentación corporativa en una IA, un proceso crítico que abordamos a fondo en nuestra guía sobre cómo configurar un Custom GPT seguro para empresas.
El proceso de tokenización: Transformar una palabra a valores numéricos
El procesamiento del lenguaje natural requiere traducir secuencias de caracteres a cifras para que la red neuronal de la IA pueda interpretarlo y procesarlo.
Este flujo se divide en tres fases:
- Tokenización (Fragmentación de caracteres): El texto se procesa por palabras completas o divisiones de estas palabras.
- Texto original: «Ciberseguridad»
- Fragmentación: [«Ciber», «seguri», «dad»]
- Codificación discreta (Asignación de IDs): Cada fragmento se contrasta con el vocabulario base del modelo (que suele tener de 50.000 a 100.000 tokens) para obtener su identificador numérico entero.
- «Ciber» → 1492
- «seguri» → 843
- «dad» → 112
- Vectorización o Embedding (Proyección matemática continua): Con cada número que forma la palabra original, y a su vez frases, se obtiene un vector, que es lo que realmente va a utilizar la IA. Cada dato numérico (llamado ID) se proyecta como un vector.
- Vector resultante: [1492,843,112]
Una vez tenemos estos vectores, el modelo determina el contexto calculando la distancia geométrica entre estos vectores.
La IA determina matemáticamente que el vector se alinea computacionalmente más con información que tiene almacenada, permitiendo a la IA «entender» relaciones complejas sin memorizar reglas gramaticales.
Una vez relaciona la información ya está listo para empezar a generar una respuesta, siguiendo un proceso similar, pero a la inversa.
El límite de memoria: La ventana de contexto
El segundo punto que hay que entender para dimensionar correctamente una infraestructura de inteligencia artificial, además de qué son los tokens IA, es el contexto.
Qué ocurre cuando saturas la memoria de un modelo (Amnesia algorítmica)
Puedes leer nuestro post de cómo funciona la ventana de contexto, pero basta con saber que la ventana de contexto es el espacio donde se almacena la información que va a tener en cuenta para generar una respuesta.
Cada modelo de lenguaje tiene un límite máximo de tokens que puede retener en su memoria a corto plazo (en la ventana de contexto).
Este límite abarca:
- Tu prompt inicial
- Los documentos o imágenes adjuntos
- El histórico de la conversación en este mismo chat
- La configuración de la memoria del modelo si la hemos hecho.
- La propia respuesta que el algoritmo está generando.
Todo este contenido es, en esencia, tokens que la IA tiene tener en cuenta para generar una respuesta.
La ventana de contexto, a su vez presenta diferentes problemas.
- Desbordamiento de búfer conversacional: Cuando la cantidad de información que tenemos en la lista anterior supera la capacidad límite de la ventana de contexto, el modelo deja de tener en cuenta parte de esa información. El problema es que no lo notamos excepto en que la IA genera respuestas que incumplen instrucciones o datos que hemos hablado en este chat.
- Inviabilidad de auditorías estáticas masivas: Si le pasamos una gran cantidad de información (como bases de datos sin procesar o históricos de ventas de cinco años) en una sola instrucción, la ventana de contexto se llenará y sobrepasará de forma inmediata.
- Degradación lógica y riesgo de fallos: Cuando llenamos la ventana de contexto, la IA deja de tener en cuenta información, lo que lleva a que se la invente, provocando alucinaciones.
Técnicas básicas para no desperdiciar capacidad de procesamiento
Para evitar la amnesia algorítmica y maximizar la precisión, los equipos de desarrollo y operaciones deben aplicar protocolos estrictos de limpieza de datos:
- Purga de metadatos y código no semántico: Antes de enviar un documento o archivo al modelo debemos limpiarlo de toda la información innecesaria como etiquetas HTML, tabulaciones excesivas o espacios redundantes, de forma que pueda centrarse en la información crítica.
- Modularidad (Chain of Thought): En lugar de generar una tarea en un solo prompt, conviene a través de una serie de prompts ir desarrollando pasos intermedios de la tarea, de forma que podamos controlar que la información que genera es correcta antes de llegar al resultado final.
El impacto financiero de los tokens en la empresa
Comprender en profundidad que son los tokens IA es el eje central de la viabilidad económica de cualquier proyecto de automatización.
Cuando la empresa usa las APIs de las IAs, el modelo de facturación no funciona como una tarifa plana (como Netlix que siempre cobra lo mismo, independientemente de cuanto lo usemos), sino en un pago por volumen de procesamiento computacional (como la factura energética que se cobra por consumo).
Facturación: Coste por token de entrada (Prompt) vs. token de salida (Generación)
Los grandes proveedores de infraestructura (OpenAI, Anthropic, Google Cloud, Microsoft) estructuran su política de dos formas:
- Tokens de entrada (Input): Representan todo el volumen de texto que la empresa envía al modelo (instrucciones, manuales, contextos previos). El coste de procesamiento es notablemente bajo, ya que el algoritmo únicamente debe leer, vectorizar y asimilar la información.
- Tokens de salida (Output): Corresponden al texto que la IA genera como respuesta. Este proceso es mucho más costoso a nivel computacional porque los servidores tienen que calcular la probabilidad matemática de cada fragmento para generar la respuesta en tiempo real. Como regla general, los tokes generados suelen ser entre tres y cuatro veces más caros que los de entrada.
- La negligencia en el Prompting comercial: Si un equipo de ventas configura un sistema automático para responder correos exigiendo a la IA respuestas de seis párrafos cuando tres líneas resolverían la incidencia, la compañía está multiplicando su gasto en tokens de salida. Estas decisiones afectan directamente a la rentabilidad de la automatización.
Domina la arquitectura base con los cursos de SocraTech
Comprender de forma aislada qué son los tokens IA es insuficiente si el equipo técnico y estratégico no sabe cómo monitorizarlos, limitarlos y optimizarlos en entornos de producción.
Delegar la implementación de inteligencia artificial sin esta base de conocimiento conduce irremediablemente a facturas descontroladas y sistemas ineficientes.
Para poder llevar a cabo este proceso es necesaria una instrucción técnica práctica y orientada a negocio, con casos de uso representativos.
En los cursos de IA generativa en directo de SocraTech para empresas transformamos el conocimiento teórico en habilidades operativas críticas para rentabilizar la tecnología en tu empresa.
Capacitamos a los profesionales para entender e implementar estas herramientas teniendo en cuenta las métricas de gasto computacional y para obtener resultados precisos optimizando las instrucciones de entrada para que se limite el volumen de los tokens de salida.
Conclusión: Optimizar tokens es optimizar rentabilidad
El en nuevo entorno corpotativo de herramientas basadas en inteligencia artificial, los tokens IA son la unidad básica del coste de producción.
Desconocer su funcionamiento es el equivalente industrial a gestionar una fábrica sin auditar el consumo energético ni el desperdicio de materia prima.
Dominar qué son los tokens IA y capacitar a la plantilla en su optimización es la única vía metodológica para escalar la automatización de la compañía de forma segura, predecible y económicamente viable.